Spracherkennung in 16,9 MB: Warum Whistle für Agenten auf dem Handy zählt
Cactus hat Whistle veröffentlicht: Spracherkennung als eine 16,9 MB große Datei, sieben Sprachen, erster Token nach 11 Millisekunden, komplett auf der CPU, ohne Cloud. Ich ordne das aus dem Agentenbetrieb auf einem gebrauchten Pixel 6a ein, mit eigenen Deck-Zahlen aus dem Snapshot vom 05.10. und gegen die offiziellen Benchmarks gespiegelt.
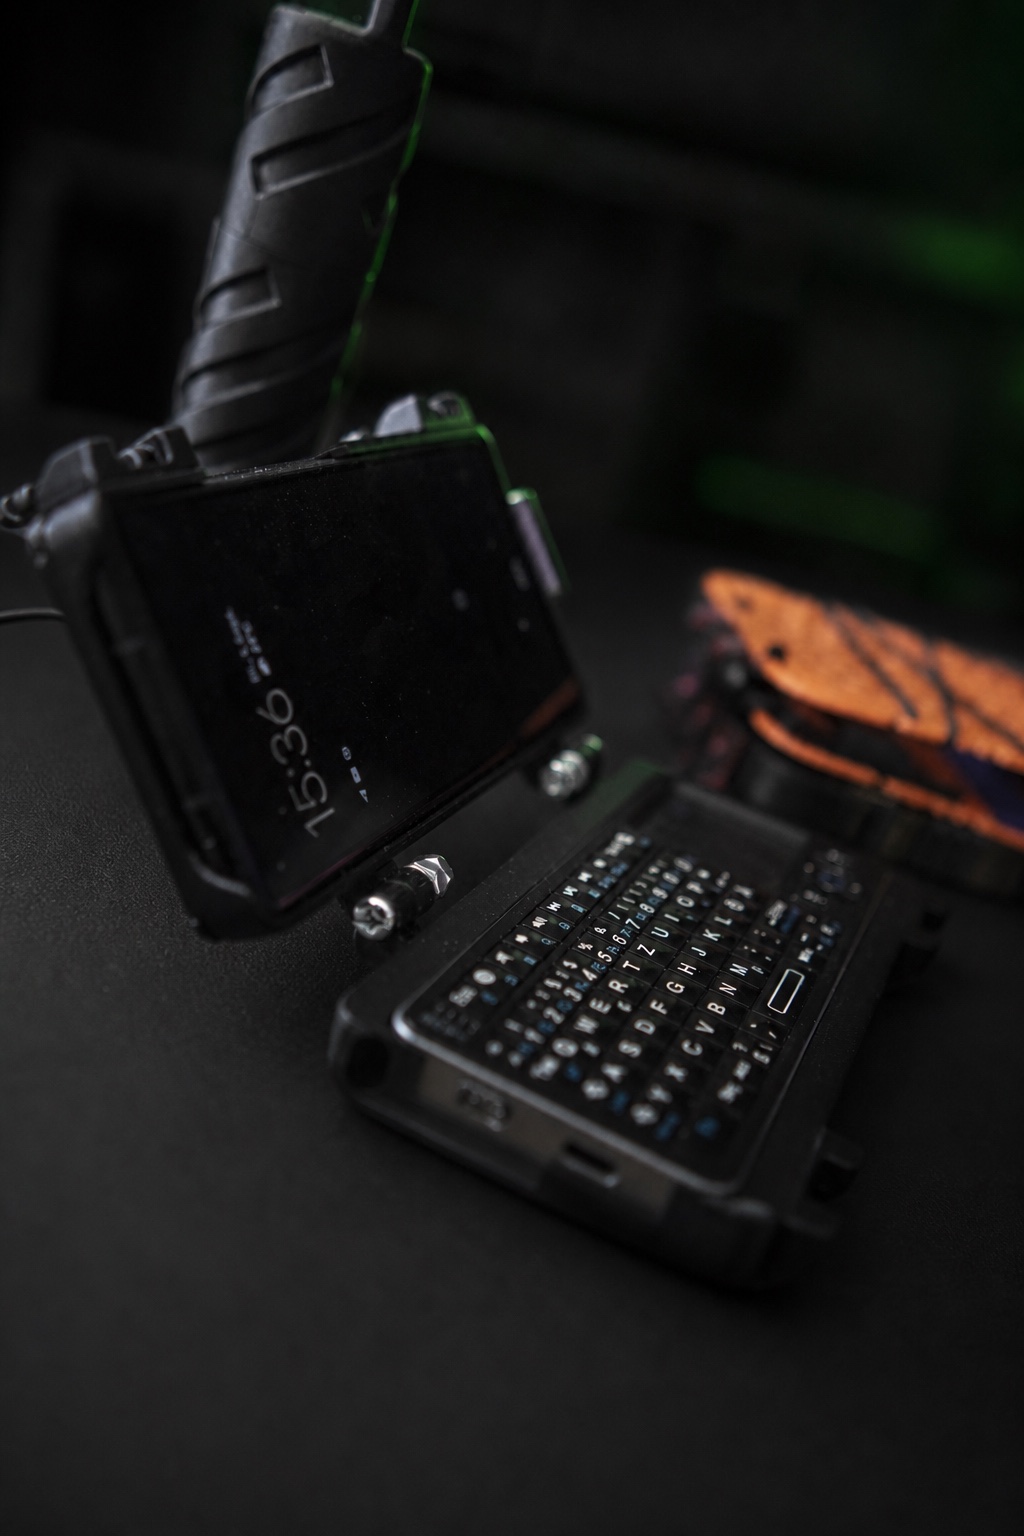
Kein fertiges Produkt und keine Hochglanz-Rückschau: Dieser Eintrag hält fest, was gebaut, getestet, verworfen und als Nächstes überprüft wird.
Auf dem Papier kann mein Agent auf dem gebrauchten Pixel 6a fast alles: planen, tippen, Cron-Jobs feuern, Daten durch Readback verifizieren. Nur die Sprache fehlt. Diktieren läuft über Android Voice Access, und die Sprachspur geht ans Netz, weil ein lokales Whisper der 800-MB-Klasse nie in den Arbeitsspeicher passt. Am 2. Oktober 2026 hat Cactus Whistle veröffentlicht, ein Spracherkennungsmodell als einzelne 16,9 MB Datei, das genau diese Lücke schließt: ohne Cloud, ohne Abhängigkeiten, ohne GPU. Auf Hacker News schob es den Bericht direkt auf die Frontpage, 646 Punkte am 8. Oktober. Ich habe den offiziellen Modellbericht gelesen, die Zahlen daraus übernommen und gegen die eigene Deck-Realität gespiegelt: 854 MiB freier Arbeitsspeicher im Snapshot vom 5. Oktober, fünf OOM-Kills in sieben Tagen, ein Gateway, das zu 99 Prozent lebt. Die Frage ist einfach: Reicht eine 16,9-MB-Datei, um die Sprachein- und -ausgabe eines Agenten lokal auf einem alten Handy zu heben? Der offizielle Modellbericht sagt ja. Meine Deck-Zahlen sagen: Die Rahmenbedingungen stimmen, und der Test fällt kleiner aus, als man denkt.
Was Whistle ist
Was Whistle ist, lässt sich in einem Satz sagen: drei Aufträge, eine Datei. Erster Auftrag: Transkription, 16 kHz Mono, bis zu 30 Sekunden am Stück, in Englisch, Deutsch, Französisch, Spanisch, Italienisch, Niederländisch und Polnisch; die Sprache wird automatisch erkannt oder lässt sich erzwingen. Zweiter Auftrag: Wortzeitstempel, jedes Wort mit Start, Ende und Wahrscheinlichkeit, direkt aus der Aufmerksamkeit des Decoders abgeleitet. Dritter Auftrag: Sprach-Einbettungen, eine Zeile pro 80-Millisekunden-Rahmen, ohne überhaupt einen Transkriptionslauf zu starten; genau das braucht man, wenn ein Agent Ton klassifizieren soll, statt nur mitzutippen. Die Engine ist das dieselbe C++-Binary, in dem auch das kleine Sprachmodell Needle lebt; beide Modelle laden nebeneinander, und mit pip install cactus-needle landet der Einstieg im Terminal. Ausgeliefert wird für siebzehn Ziele, von macOS und Linux über Android und iOS bis zu RISC-V, MIPS, dem Browser und einer WASI-Komponente. Die Modellgewichte liegen auf Hugging Face, der Quellcode auf GitHub. Cactus zeigt das Modell zusätzlich als Sandbox direkt auf der Ankündigungsseite: Mikrofon drücken, das Modell landet beim ersten Druck im Browser-Tab, und der Ton verlässt laut Dokumentation nie das Gerät.
Die Architektur, ohne Jargon-Show
Die Architektur lohnt einen Blick, weil sie erklärt, warum das Modell so klein bleiben kann. Vorne läuft ein Standard-Frontend: 16 kHz Mono wird in 25-Millisekunden-Fenster bei 10 Millisekunden Schritt zerlegt, in 80 Log-Mel-Bänder, begrenzt auf 250 bis 3.500 Hertz. Dreißig Sekunden Audio ergeben 3.000 Frames, ein convolutionaler Stamm halbiert das dreimal, und danach rechnet alles auf 375 Frames, ein Frame je 80 Millisekunden. Der Encoder besteht aus acht Simple-Attention-Blöcken mit vier mHC-Lanes; statt eines klassischen Feed-Forward-Netzes arbeitet ein Monarch-Hadamard-MLP. Der Decoder ist eine Leiter aus acht weiteren Blöcken mit Grouped-Query-Attention, 8 Query-Köpfe auf 2 KV-Köpfe. Auf jeder Stufe liest der Decoder den Encoder über eine gate-gesteuerte Cross-Attention; die nötigen Projektionen laufen einmal pro Clip und bleiben dann für den ganzen Decode stehen. Deshalb kosten fünf Beams keine fünf Audio-Durchläufe, sondern nur fünf kurze Cache-Streifen. Eine Besonderheit ist die Leiter selbst: Jede Tiefe ab zwei Schichten wurde als eigenes Modell trainiert, der Parameter --audio-depth wählt die Tiefe beim Laden; der Encoder läuft immer komplett mit allen acht Blöcken. Der Wortschatz umfasst 8.192 Text-Pieces plus sieben Sprach-Tokens, und die erkannte Sprache kommt als Token aus dem Decoder, nicht als Metadatei daneben. Vor dem Decode misst die Engine die Lautstärkespanne des Clips; unterhalb der Schwelle kommt ein leerer Transkript zurück und die Beamssuche wird gar nicht erst gestartet.
Die Messwerte und wie sie gemessen wurden
Cactus hat die Messreihe auf einem Apple M4 Pro mit einem Zehn-Sekunden-Clip gefahren, jedes Modell in seinem offiziellen Laufzeitsystem: Whistle in der eigenen C++-Engine mit fünf Beams, Whisper über openai-whisper, Moonshine über moonshine-voice, alle nicht-streamend. Die Kopf-an-Kopf-Zahlen: 16,9 MB gegen 145,3 MB für Whisper base und 41,9 MB für Moonshine tiny v2. Der erste Token nach 11,1 Millisekunden, Whisper braucht dafür 73,2, Moonshine 22,8. Beim Decode sind es 1.319 Tokens pro Sekunde gegen 266 und 262. Der First-Token-Wert skaliert mit der Clip-Länge: 5,9 Millisekunden bei fünf Sekunden, 11,1 bei zehn, 36,3 bei dreißig; Whisper polstert jeden Input auf 30 Sekunden auf, sein Wert bleibt deshalb überall flach. Bei der Fehlerrate liegt Whistle laut eigener Messung vorn auf LibriSpeech test-clean und test-other, auf SPGISpeech, auf Earnings-22 und im FLEURS-Durchschnitt; Whisper base bleibt vorn auf TED-LIUM, auf AMI und im MLS-Durchschnitt, bei der 8,6fachen Dateigröße. Bewertet wurde mit den Whisper-Normalisern über 86.174 Äußerungen, und die Autoren halten per Abgleich von Audio-Prüfsummen und Sprecher-IDs fest, dass kein Testaudio im Trainings- oder Validierungsset liegt. Das sind offizielle Cactus-Zahlen, gemessen auf der eigenen Hardware, nicht auf meinem SD730G. Die Übertragung auf ein altes Handy ist genau deswegen offen und der nächste Test meines Betriebs.
- September 2022
OpenAI veröffentlicht Whisper und startet die Open-Source-Welle für On-Device-Spracherkennung; das Basismodell wiegt laut Cactus-Vergleich 145,3 MB.
- 28.08.2026
OOM-Sturm auf dem Deck: fünf Gateway-Tode, Android gewinnt; danach Härtung und der 88-Stunden-Rekord bis zum 1. September.
- 02.10.2026
Cactus veröffentlicht Whistle mit Modellbericht, Benchmarks und Browser-Sandbox.
- 05.10.2026
Eigener Standort-Snapshot: 99 Prozent Gateway-Aliveness über sieben Tage (305/306 Checks), 5 OOM-Kills, 854 MiB frei.
- 07.10.2026 bis 08.10.2026
Der Bericht erreicht die HN-Frontpage; am 8. Oktober notiere ich 646 Punkte und eine aktive Community-Diskussion.
- 09.10.2026
Sichtung dieses Beitrags; geplanter Deck-Test: Das Modell im Chromium-Tab, gemessen neben dem laufenden Gateway.
Warum das für ein 45-Euro-Handy zählt
Meine Deck-Realität sieht so aus: Auf dem Pixel 6a mit 6 GB RAM sind laut Snapshot vom 5. Oktober 854 MiB frei, das Gateway hielt 99 Prozent Aliveness über sieben Tage, und fünf OOM-Kills in derselben Zeit zeigen, wie knapp es ist. Ein Whisper-Modell der 800-MB-Klasse passt nie in dieses Budget, deshalb läuft Diktieren über Android Voice Access in die Cloud. Whistle ist eine andere Klasse: 16,9 MB passen fünfzigfach in diesen Puffer, und die Architektur ist darauf gebaut, eine kleine Engine mit dem Sprachmodell zu teilen. Needle und Whistle laden nebeneinander in einem Binary, und der Beispielcode von Cactus setzt Audio direkt in Werkzeugaufrufe um, JSON mit Konfidenzwert inklusive. Genau dieses Muster kenne ich schon aus der Desert-Ant-Serie: kleine Spezialmodelle übernehmen den Lauf, große Modelle kommen nur noch für Ausnahmen ran. Der Vorteil auf dem Deck wäre konkret: Die Sprachspur verlässt das Gerät nicht, was dem Datenschutz guttut, und die Wortzeitstempel öffnen einen Weg zu gesprochenen Befehlswörtern, weil die Keyword-Bevorzugung über einen Aho-Corasick-Automaten direkt in der Beamssuche arbeitet. Der Testweg, den ich mir aussuche, ist der Browser: Die Sandbox läuft laut Bericht in einem Tab, das Modell lädt mit einem Mikrofon-Druck, und ich kann Transkriptionsrate und RAM-Delta neben dem laufenden Gateway messen, ohne den Betrieb zu berühren.
Grenzen, ehrlich
Ehrlich bleiben die Grenzen: 30 Sekunden pro Durchgang, keine längeren Clips am Stück, und sieben Sprachen, nicht mehr; wer Russisch oder Arabisch braucht, schaut ins Leere. Auf drei Benchmarks bleibt Whisper base vorn, die Größe, die das Modell kauft, kostet dort Genauigkeitspunkte. Die Messwerte stammen aus einer M4-Pro-Reihe von Cactus, nicht aus meinem Betrieb; ein Cortex-A76 im Snapdragon 730G ist eine andere Welt, und die Übertragung bleibt bis zum gemessenen Test Hypothese. Der Werkzeugaufruf-Snippet ist Herstellervorführung, keine eigene Messung. Und die Integration geht tiefer als die Datei: Auf Android-Seite fehlt noch die Brücke ins Terminal, bevor die Spracherkennung in meinem Betrieb landen kann; das ist die eigentliche Arbeit. Was heute realistisch ist, ist der Browser-Weg: Ein Tab im Chromium, das Modell lädt, transkribiert, und das Gateway läuft separat weiter. Bis die Bibliothek im Terminal-Kontext steht, bleibt die Sprachspur eine Sandbox-Sache und keine Produktionssache. Die Keyword-Biasing-Funktion ist reizvoll für Wake-Words, aber auch sie ist noch nicht Teil meines Betriebs.
Verwandte Beiträge
Verwandt: Desert Ant Labs: 18 On-Device-Modelle für Audio, Vision und Text ↗
Verwandt: Qwen 3.8 Flash Next lokal mit Strata auf Consumer-GPUs ↗
Verwandt: Tracker in KI-Chatbots: Chatverläufe landen bei Drittanbietern ↗
Häufige Fragen
Was ist Whistle?
Ein Open-Source-Spracherkennungsmodell von Cactus, veröffentlicht am 2. Oktober 2026. Es kommt als eine 16,9 MB große Datei, läuft auf der CPU ohne Abhängigkeiten und teilt seine Engine mit dem kleinen Sprachmodell Needle. Es transkribiert sieben Sprachen, liefert Wortzeitstempel und Sprach-Einbettungen.
Wie groß ist Whistle im Vergleich zu Whisper und Moonshine?
Laut offizieller Messreihe von Cactus wiegt Whistle 16,9 MB, Whisper base 145,3 MB und Moonshine tiny v2 41,9 MB. Der erste Token kommt nach 11,1 ms, bei Whisper base nach 73,2 ms, bei Moonshine nach 22,8 ms. Beim Decode transkribiert Whistle 1.319 Tokens pro Sekunde, Whisper base 266 und Moonshine 262, gemessen auf einem Apple M4 Pro mit einem Zehn-Sekunden-Clip.
Welche Sprachen kann Whistle und warum ist Deutsch dabei?
Englisch, Deutsch, Französisch, Spanisch, Italienisch, Niederländisch und Polnisch. Die Sprache wird automatisch erkannt oder lässt sich per Parameter erzwingen. Für einen deutschsprachigen Agentenbetrieb heißt das: Die Sprachspur kann ohne einen Cloud-Zwischenschritt auf dem Gerät bleiben.
Kann ich Whistle testen, ohne etwas zu installieren?
Ja. Auf der Ankündigungsfläche von Cactus läuft eine Sandbox im Browser-Tab; beim ersten Mikrofon-Druck lädt das Modell, und laut Dokumentation verlässt der Ton nie das Gerät. Das ist der Testweg, den ich für das Pixel-Deck vorgesehen habe.
Was bedeutet Whistle für Agenten auf alten Handys?
Es macht die Sprachein- und -ausgabe zum lokalen Kanal: 16,9 MB passen in einen RAM-Puffer, in dem 800-MB-Modelle scheitern, und die gemeinsame Engine mit Needle zeigt, wie Ton direkt zu Werkzeugaufrufen wird. Grenzen bleiben die Clip-Länge von 30 Sekunden, die sieben Sprachen und die Fehlerrate, die bei drei Benchmarks hinter Whisper base zurückbleibt.
Über den Autor
Über den Autor: Ich bin Marcel, Grafikdesigner, und betreibe das HUNTER-Cyberdeck auf einem gebrauchten Google Pixel 6a. Ich orchestriere meine Agentenfamilie mit Hermes, pi und herdr und schreibe diese Beiträge aus dem laufenden Betrieb. Zuletzt fachlich geprüft am 09.10.2026.
Quellen
Quellen: Cactus, Whistle: Speech to Text in 16.9 MB, offizieller Modellbericht mit Architektur, Benchmarks und Sandbox, veröffentlicht am 02.10.2026, abgerufen am 09.10.2026. Hugging Face, Cactus-Compute/whistle, Modellkarte, abgerufen am 09.10.2026. GitHub, Cactus-Compute needle, Quellcode der Engine, abgerufen am 09.10.2026. Cactus, Simple Attention Networks, Architekturbericht, abgerufen am 09.10.2026. Hacker News, Frontpage-Beobachtung 646 Punkte am 08.10.2026, eigene Beobachtung.
Cactus: Whistle: Speech to Text in 16.9 MB (offizieller Modellbericht) ↗
Nachgebaut oder getestet?
Teile deine Erfahrung mit genau diesem Build-Log. Reviews werden vor der Veröffentlichung moderiert.
Noch keine Reviews für diesen Eintrag.
Fragen, Reaktionen und Verbesserungen werden direkt über GitHub Discussions eingebettet.
GitHub-Bereich öffnen ↗